Поиск по регламентам для ИИ-ассистента 1С: как устроен RAG
В первой статье цикла мы разобрали, как ИИ-ассистент для 1С берет цифры из живой базы через HTTP-сервисы. Здесь — вторая половина задачи: вопросы, ответ на которые записан в тексте регламента или инструкции. Разбор для ИТ-специалистов: как устроен поиск по документам (RAG), какие модель и хранилище мы используем у себя, как совместить поиск по смыслу и по словам, соблюсти права и не проиндексировать отмененные редакции.
Руководителю, которому важнее, с чего начать и что подготовить, подойдет обзорная статья ИИ-ассистент по регламентам: сначала порядок в документах.
Чем вопрос к регламенту отличается от вопроса к 1С
Остаток на складе или долг клиента — поле в регистре. Модель выбирает функцию, 1С возвращает число, ошибка возможна лишь в параметрах. Ответ про командировку лежит в абзаце текста, и сотрудник формулирует вопрос своими словами: пишет «поездка в филиал», а в положении — «служебная командировка». Поиск по точному совпадению такой абзац не найдет.
Языковая модель без документов уверенно опишет порядок «в среднем по рынку» — с чужими сроками и формами. Подход RAG (retrieval-augmented generation, генерация с опорой на найденное) меняет порядок: сначала система находит в документах компании несколько подходящих фрагментов, затем модель отвечает только по ним и показывает, откуда взят ответ.
Как устроен поиск: путь документа и вопроса
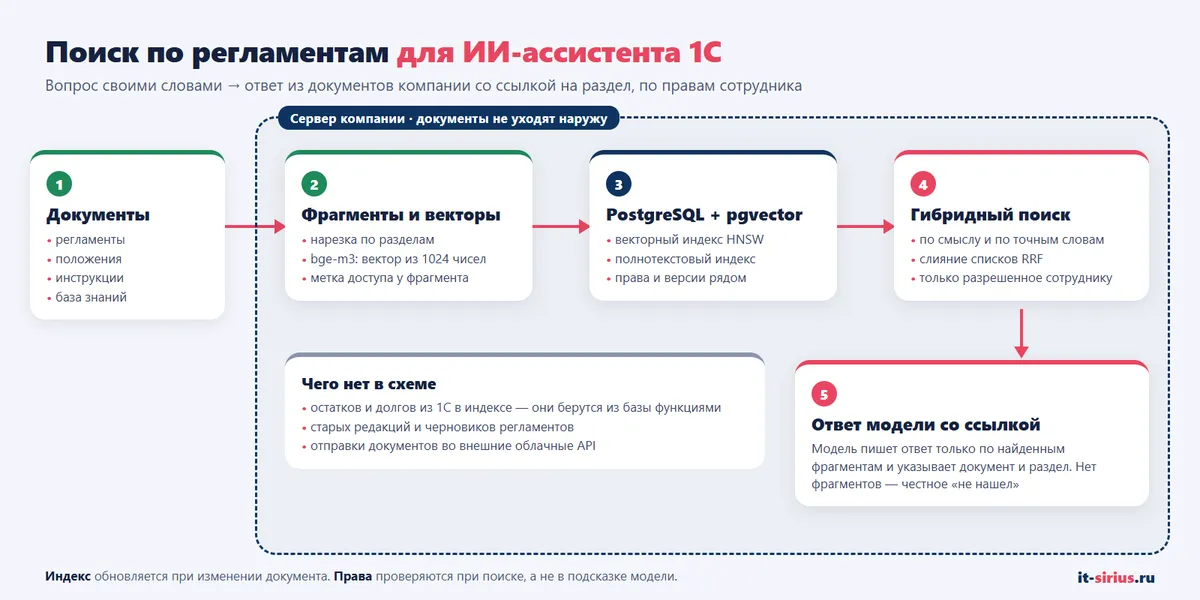
Работа делится на две части. Индексация готовит документы заранее и повторяется при их изменении. Поиск выполняется на каждый вопрос. Номера на схеме совпадают с шагами ниже.
- Документы. Регламенты, положения, должностные и рабочие инструкции, статьи базы знаний. Текст извлекается из DOCX, PDF с текстовым слоем и страниц вики. К каждому документу привязываются название, дата редакции и круг тех, кому он доступен.
- Фрагменты. Документ режется на куски примерно по 1200 знаков с перекрытием 150 знаков, чтобы мысль на границе не потерялась. Границы стараемся совмещать с пунктами и разделами, к фрагменту прикрепляются название документа и заголовок раздела — по ним потом строится ссылка.
- Эмбеддинги. Модель bge-m3 превращает каждый фрагмент в вектор из 1024 чисел. Близкие по смыслу тексты дают близкие векторы без общих слов: «поездка в филиал» оказывается рядом с «командированием работника».
- Хранилище. Векторы, исходный текст, полнотекстовый индекс и метки доступа лежат в одной таблице PostgreSQL с расширением pgvector. Для быстрого поиска ближайших векторов построен индекс HNSW по косинусной близости.
- Гибридный поиск. Вопрос сотрудника превращается в вектор той же моделью. Система ищет двумя способами — по смыслу и по словам, — сливает результаты и отбрасывает фрагменты, которые этому сотруднику не положены. На выходе 3–5 лучших фрагментов.
- Ответ. Модель получает вопрос и найденные фрагменты с инструкцией: отвечать только по ним и указать документ и раздел. Сотрудник видит короткий ответ и ссылку на первоисточник.
До индексации: версии, дубли и противоречия
Когда клиент готов к внедрению и мы просим регламенты, ответ часто один: «Все на сетевой шаре Z:\, папки по отделам». Там вперемешку сканы, чеки, отчеты, презентации и по несколько редакций одного положения в разном оформлении. Проиндексировать такую папку целиком — значит получить поиск, который честно находит фрагменты отмененных редакций, и модель, которая уверенно по ним отвечает.
Определить действующую редакцию автоматически не получается. Дата изменения файла сдвигается при любом пересохранении, дата утверждения в тексте есть не всегда, похожее название ничего не гарантирует. На внедрениях 1С мы регулярно видим и другое: регламент расходится с реальным процессом, и по тексту этого не понять. Поэтому индексации предшествует аудит документов, а индексатор работает по реестру.
- Реестр. У каждого документа — владелец, статус (действует, архив, черновик), дата утверждения и ссылка на редакцию, которую он заменил. В индекс попадает только статус «действует».
- Дубли. Точные копии находятся по хэшу нормализованного текста, почти совпадающие редакции — по близости векторов документов. Пары уходят владельцам на решение, автоматически ничего не удаляется.
- Лишнее. Чеки, отчеты, презентации и сканы без текстового слоя отсеиваются до нарезки.
- Противоречия. Если фрагменты двух действующих документов отвечают на вопрос по-разному, ассистент показывает оба с датами редакций, а вопрос попадает в журнал для владельцев.
Поля реестра прикрепляются к каждому фрагменту рядом с меткой доступа. Перевод документа в архив убирает его фрагменты из индекса так же, как удаление файла. Где регламента нет или он устарел, сначала описываем процесс по интервью с сотрудниками, которые его ведут, — подробнее об этом в обзорной статье.
Модель эмбеддингов: почему bge-m3
Векторная модель — отдельная небольшая нейросеть: она не пишет текст, а переводит его в векторы. От нее зависит, найдется ли нужный абзац. Мы используем BAAI/bge-m3 по трем причинам: она хорошо работает с русским языком, принимает длинные тексты (до 8192 токенов) и распространяется по открытой лицензии MIT — разворачивается на своем сервере без оплаты за запросы.
Запускаем ее в Text Embeddings Inference — сервере от Hugging Face, который отдает векторы по HTTP. Требования скромнее, чем у языковой модели: у нас bge-m3 работает на видеокарте с 6 ГБ памяти рядом с другими задачами. Без видеокарты модель работает, но первичная индексация большого архива идет дольше. Правило: документы и вопросы обязаны проходить через одну и ту же модель. Сменили модель — переиндексируйте весь архив.
Где хранить векторы: pgvector или отдельная база
Для векторов есть специализированные базы — Qdrant, Milvus, Weaviate. Они оправданы, когда фрагментов миллионы и поиск нагружен тысячами запросов. Регламентов у типичной компании — сотни документов, то есть десятки тысяч фрагментов, и с таким объемом PostgreSQL с pgvector справляется без отдельного сервера.
Главный довод за pgvector — не скорость. В одном SQL-запросе соединяются векторный поиск, полнотекстовый поиск и фильтр по правам, а база уже есть в инфраструктуре: один бэкап, один мониторинг, привычное администрирование. Отдельная векторная база — дополнительный сервис, который нужно обновлять, защищать и синхронизировать с правами.
Гибридный поиск: смысл и точные слова
Векторный поиск ловит перефразировки, но промахивается на точных обозначениях: номер приказа, форма Т-9, артикул, код ошибки. Для вектора «приказ № 15-к» и «приказ № 51-к» почти одинаковы. Полнотекстовый поиск PostgreSQL находит их точно, но не понимает синонимов. Мы запускаем оба поиска и объединяем результаты.
Объединение — метод RRF (Reciprocal Rank Fusion). Из каждого списка берутся 50 лучших фрагментов, и каждый получает очки по формуле 1 / (60 + место в списке). Фрагмент, который высоко стоит в обоих списках, поднимается наверх. Веса подбирать не нужно, а несопоставимые оценки двух поисков методу не мешают. Практический плюс: если сервис эмбеддингов недоступен, поиск продолжает работать по словам, а недостающие векторы досчитываются после восстановления.
Права доступа на уровне фрагмента
Положение о премировании руководителей не должно всплыть в ответе кладовщику, спросившему про премии. Метка доступа хранится у каждого фрагмента: каким ролям, отделам или сотрудникам он виден. Фильтр по правам стоит внутри обоих поисков, до слияния списков. Модель получает лишь то, что сотрудник вправе открыть сам.
При выдаче доступ повторно сверяется с исходным документом: если права изменили после индексации, старая метка не откроет лишнего. Фрагменты с персональными данными помечаются отдельно. Запрет в подсказке модели («зарплаты не показывать») — пожелание, а не ограничение доступа.
Как индекс остается актуальным
Для каждого фрагмента хранится хэш содержимого. При изменении документа фоновая задача перерезает и пересчитывает его фрагменты, остальной индекс не трогается. Документ, удаленный или переведенный в архив, забирает с собой и свои фрагменты: утвердили новую редакцию в реестре — старая уходит из поиска. В ответе показывается дата редакции, чтобы сотрудник видел, на что опирается ответ.
Ответ со ссылкой и честное «не нашел»
Пример ответа на вопрос о командировке: «Заявку на командировку руководитель отдела оформляет не позднее чем за три рабочих дня до выезда, авансовый отчет сдается в течение трех рабочих дней после возвращения. Источник: Положение о служебных командировках, раздел 4, редакция от 01.03». Сроки здесь условные, в рабочем ответе они берутся из вашего документа.
Если подходящих фрагментов нет или они слабо похожи на вопрос, ассистент так и говорит: «В загруженных документах ответа не нашел, вопрос передан в отдел кадров». Это полезнее выдуманного ответа. Журнал вопросов без ответа показывает, каких правил в компании не хватает или где документ написан непонятно.
Как поиск по документам работает вместе с 1С
Для ассистента поиск по документам — функция в каталоге MCP-сервера рядом с функциями 1С. Модель выбирает, куда обратиться. На вопрос «Сколько дней отпуска у меня осталось и как его оформить?» она вызовет обе: остаток дней придет из ЗУП, порядок оформления — из положения об отпусках, и ответ соберется из двух источников, каждый со своей ссылкой.
Обратное правило: живые данные 1С — остатки, долги, оплаты — в векторный индекс не загружаются. Они меняются каждую минуту, а индекс отвечал бы вчерашними цифрами.
Как мы проверили это на себе
Описанная связка работает в поиске нашего портала технической поддержки. Там проиндексировано больше 10 тысяч фрагментов: статьи базы знаний, заявки клиентов, переписка по заявкам и письма. Векторы считает bge-m3 на собственном сервере, PostgreSQL хранит векторы и полнотекстовый индекс, результаты сливаются через RRF, права проверяются на уровне фрагмента. На этой же основе мы строим поиск по документам для ИИ-ассистента.
Типичные ошибки
- Индексировать сетевую папку целиком, без реестра действующих редакций. Черновики, старые редакции и копии «итог_финал2» дают противоречивые ответы;
- Определять свежую редакцию по дате изменения файла. Ее сдвигает любое пересохранение, решение принимает владелец документа;
- Резать текст на куски фиксированной длины без заголовков. Фрагмент «срок — 3 дня» без названия раздела бесполезен: неясно, к чему он относится, и ссылку не построить;
- Ограничиться только векторным поиском. Номера приказов, формы и коды он находит плохо, полнотекстовый поиск закрывает пробел;
- Проверять права после того, как модель написала ответ. Закрытый фрагмент к этому моменту уже прочитан моделью и может попасть в пересказ. Фильтр должен стоять в самом поиске;
- Показывать ответ без источника. Сотрудник не может проверить ответ и заметить ошибку;
- Не измерять качество. Без набора контрольных вопросов с известными ответами непонятно, помогла ли смена модели или другая нарезка.
Как проходит внедрение
- Аудит документов. Составляем реестр: владельцы, действующие редакции, архив, список противоречий. Собираем 30–50 реальных вопросов сотрудников и определяем, кто какие документы должен видеть.
- Индексация на тестовом сервере. Настраиваем извлечение текста, нарезку по разделам, векторную модель и метки доступа, загружаем первые документы.
- Проверка. Прогоняем контрольные вопросы и считаем, в какой доле ответов найден правильный раздел. Правим нарезку и описания документов.
- Запуск для одного отдела. Подключаем поиск к ассистенту, по журналу «не нашел» дополняем документы и расширяем круг пользователей.
Состав работ и сроки фиксируем после аудита: они зависят от числа документов, их формата и того, как устроены права доступа.
Частые вопросы
DOCX, PDF с текстовым слоем, страницы вики и статьи базы знаний. Сканы сначала проходят распознавание текста, и качество ответа зависит от качества скана. Таблицы в документах лучше дополнить текстовым описанием.
Нет. Векторная модель bge-m3 у нас работает на карте с 6 ГБ памяти, а без видеокарты медленнее индексирует. Мощная видеокарта нужна языковой модели, которая пишет ответ, — об этом в первой статье цикла.
Сотни страниц не помещаются в контекст локальной модели, а при большом контексте ответ готовится долго и детали в середине текста теряются. Права при передаче всего подряд не соблюсти: модель увидит документы, закрытые для сотрудника.
Да. Тексты файлов и права на них забираются из 1С:Документооборота через HTTP-сервис, а дальше документы проходят ту же нарезку и индексацию, что и файлы из сетевой папки.
Только решением владельца документа. Поэтому до индексации составляется реестр со статусом каждой редакции, и в индекс попадает только действующая. Если противоречие всплыло позже, ассистент показывает оба фрагмента с датами, а вопрос уходит владельцам.
После сохранения новой редакции фоновая задача пересчитывает фрагменты только этого документа, переиндексация всего архива не нужна. Ассистент начинает отвечать по новой редакции, как только задача завершится.
Нет. Векторная модель, база с векторами и языковая модель работают на сервере компании, документы и вопросы сотрудников наружу не передаются.
Статьи цикла
- ИИ-ассистент для 1С на локальной модели: MCP-сервер и закрытый контур — из чего состоит ассистент, выбор модели и видеокарты, HTTP-сервисы и права;
- Поиск по регламентам для ИИ-ассистента 1С: как устроен RAG — вы читаете эту статью.
Пришлите список регламентов и инструкций, по которым сотрудники чаще всего задают вопросы, — специалист по 1С оценит, какие документы подойдут для поиска, и предложит план внедрения.

